Meta предложила дать ИИ-агентам контроль над собственным контекстом
Исследователи из Meta предложили Context Language Models — подход, при котором модель сама переписывает собственную историю контекста через файл и Bash. Обучение через RL подняло Qwen3.5–9B на BrowseComp-Plus с 28.8% до 42.5%.
- В CLM весь контекст хранится в файле, доступном модели через Bash, и она сама решает, что удалить или сжать.
- После RL-обучения Qwen3.5–9B на BrowseComp-Plus выросла с 28.8% до 42.5% при экономии вычислений 38.8%.
- Suffix Cache Reuse сократил серверные вычисления ещё примерно на 35% без заметной потери качества.
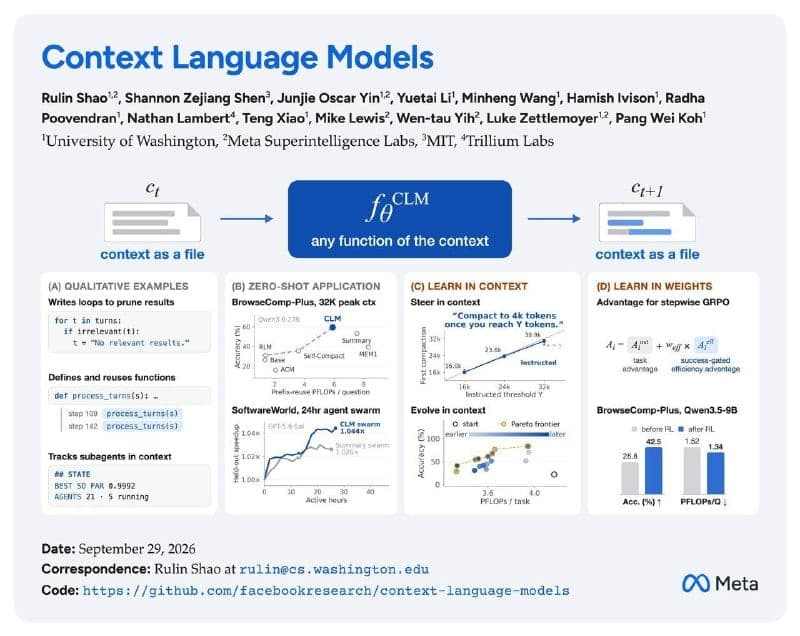
Исследователи из Meta предложили подход Context Language Models (CLM), в котором модель сама управляет собственным контекстом. Обычно история агента растёт по простой схеме: старый контекст плюс новый ответ. Когда она становится слишком большой, её отдельно сжимают или чистят. В CLM эту логику убирают и дают модели возможность переписывать историю самостоятельно.
Технически весь текущий контекст хранится в обычном файле, к которому у модели есть доступ через Bash. В любой момент она может удалить ненужные сообщения, заменить большой кусок истории короткой заметкой, сохранить результат дословно или полностью перестроить содержимое. После каждого изменения файл становится новым контекстом модели. Никаких правил о том, как именно управлять историей, ей не дают.
В экспериментах агенты сами начинали заводить внутри контекста пометки, писать функции для удаления старых результатов поиска и собирать компактные таблицы с состоянием других агентов. В одном из тестов модель за 163 редактирования удерживала рабочий контекст в пределах 6–8K токенов.
Обучение через RL и результаты
Авторы отдельно обучили модель этому навыку через RL. После обучения Qwen3.5–9B на BrowseComp-Plus выросла с 28.8% до 42.5%, при этом на вычисления ушло на 38.8% меньше, чем у обученного тем же способом бейзлайна с обычной суммаризацией.
Произвольное редактирование контекста ломает обычное кеширование: если изменить что-то в середине истории, все состояния после этого места формально приходится считать заново. Для этого авторы сделали Suffix Cache Reuse — для неизменившихся частей контекста продолжают использовать старый KV-cache, даже если текст перед ними поменялся. В экспериментах это сократило серверные вычисления ещё примерно на 35% без заметной потери качества.
На длинных задачах разница становится заметнее. На 12-часовом EdgeBench CLM получил на 5% больше баллов при сокращении объёма вычислений на 59%. В 24-часовом тесте на оптимизацию кода CLM при том же вычислительном бюджете показал на 65% лучший результат, чем бейзлайн. Всё это работает поверх обычных LLM, без изменения архитектуры самой модели.
Для профиТехнические детали: архитектура, цифры, ссылки
Context Language Models (CLM) не меняют архитектуру базовой LLM: весь контекст хранится в файле, доступном модели через Bash, а после каждого редактирования файл становится новым контекстом. Правила управления историей модели не задаются.
- После RL-обучения Qwen3.5–9B на BrowseComp-Plus: рост с 28.8% до 42.5% при экономии вычислений 38.8% относительно бейзлайна с суммаризацией.
- Suffix Cache Reuse переиспользует KV-cache для неизменившихся частей контекста, сокращая серверные вычисления примерно на 35% без заметной потери качества.
- На 12-часовом EdgeBench: +5% баллов при сокращении вычислений на 59%. В 24-часовом тесте на оптимизацию кода: +65% при том же вычислительном бюджете.
Код доступен в репозитории facebookresearch/context-language-models, статья — arXiv:2609.37725.
Вопросы и ответы
- Что такое Context Language Models?
- Подход, в котором модель сама управляет своим контекстом: хранит историю в файле с доступом через Bash и в любой момент может её переписать.
- Насколько выросла Qwen3.5–9B после обучения?
- На BrowseComp-Plus результат вырос с 28.8% до 42.5% при экономии вычислений 38.8%.
- Нужно ли менять архитектуру модели?
- Нет, CLM работает поверх обычных LLM без изменения архитектуры.